


模型优化入门
本课程将介绍模型优化的概念。
为什么优化很难?
一个权重的最优值依赖于其他权重的取值。多个权重会同时被优化。通过梯度(斜率)我们可以判断应增加或减少哪些权重。然而,这些更新可能并不会显著提升模型性能,这就需要调整超参数。
模型参数 vs. 超参数
模型参数是模型的内部参数。在神经网络中,模型参数即神经元的权重。它们在训练过程中自动学习,之后用于进行预测。
超参数是模型的外部参数。由模型开发者手动设定,包括激活函数的选择、优化器的选择、批量大小(batch size)和训练轮数(epochs)。超参数对神经网络的准确性有显著影响。
超参数:优化方法
可以通过试错法来优化超参数,但目前尚无统一的最佳方案。
与神经网络结构相关的超参数
1. 模型复杂度
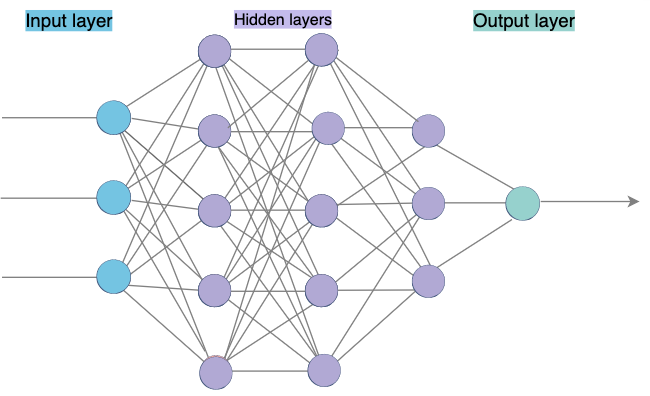
这决定了隐藏层的数量或每层的节点数量。通常,增加模型复杂度可以提高准确率。
📝 了解更多关于模型复杂度的内容。
**2. Dropout**
该参数定义了在训练过程中随机“关闭”多少神经元,以防止网络过度学习训练数据中的细节特征。
3. 激活函数
在前向传播过程中,每一层都应使用最合适的激活函数。激活函数会影响网络的收敛能力、对不同输入范围的适应性以及训练速度。
我们已在前面讨论过不同的激活函数。
-
ReLU 激活函数存在“神经元死亡”问题。当输入为零或负值时,其梯度变为零,导致反向传播无法进行,网络无法继续学习。这提示我们应选用梯度永不为零的激活函数。
-
tanh 激活函数是一个不错的选择,但存在梯度消失问题。在反向传播中,可能出现极小或接近零的梯度。这种现象在仅有少量隐藏层的网络中尚可接受,但在深层神经网络中,反复相乘会使梯度趋近于零,导致反向传播几乎失效。因此,应选择梯度不会平坦的激活函数。
与神经网络训练相关的超参数
在训练过程中,我们可能希望优化学习率、优化算法、训练轮数和批量大小。
1. 学习率:
- 学习率过小会导致更新幅度太小。
- 学习率过大则可能导致更新幅度过大。
使用如 Adam 这类智能优化器有助于缓解问题,但仍可能存在优化困难。最简单的方法是使用随机梯度下降(Stochastic Gradient Descent,简称 sgd)来观察不同学习率的效果。该优化器采用固定学习率,但可通过 lr 参数指定具体数值。
2. 轮数(Epochs)、迭代次数与批量大小:
如果由于样本量过大或网络过于复杂而无法一次性处理全部数据,则需将数据划分为多个批次,一轮训练可能需要多次迭代完成。轮数和每轮的批次数对模型训练有重大影响,可能引发欠拟合或过拟合。
📝 了解欠拟合与过拟合的相关内容。
3. 验证集:
模型的目标是在训练集上表现良好,并能在测试集上实现良好的泛化能力。验证集的作用在于:它从训练集中分离出来,在训练过程中用于监控性能,帮助决定何时停止训练,从而避免过拟合。
📝 了解更多关于模型验证的内容。
总结
- 模型参数是模型的内部参数,超参数是模型的外部参数。
- 与模型结构相关的超参数包括模型容量、Dropout 和激活函数。
- 在训练过程中可优化的超参数包括学习率、轮数和批量大小。
- 训练数据可划分为训练集和验证集,验证集有助于模型在测试集上实现更好的泛化能力。
Quiz
请选择所有被视为模型内部参数的选项。