


Redis 集群介绍
本节课将介绍 Redis 集群。
在本课程的前一节中,我们讨论了复制和分片的诸多概念。尽管这些概念看似简单,但在节点频繁增减的情况下,处理分片仍然十分困难。Redis 集群正是为了解决这一问题而设计的自动化方案。
经过四年的开发,Redis Cluster 随 Redis 3.0.0 版本于 2015 年 4 月 1 日正式发布。根据创始人所述:
“……本质上是一种数据分片策略,能够在集群运行时自动重新分配键到其他节点,同时具备故障转移机制,确保系统能够应对某些类型的故障。”
Redis 集群的两大核心优势是:
- 自动将数据集分布在多个节点之间。
- 当部分节点发生故障或无法与其他节点通信时,仍能继续提供服务。
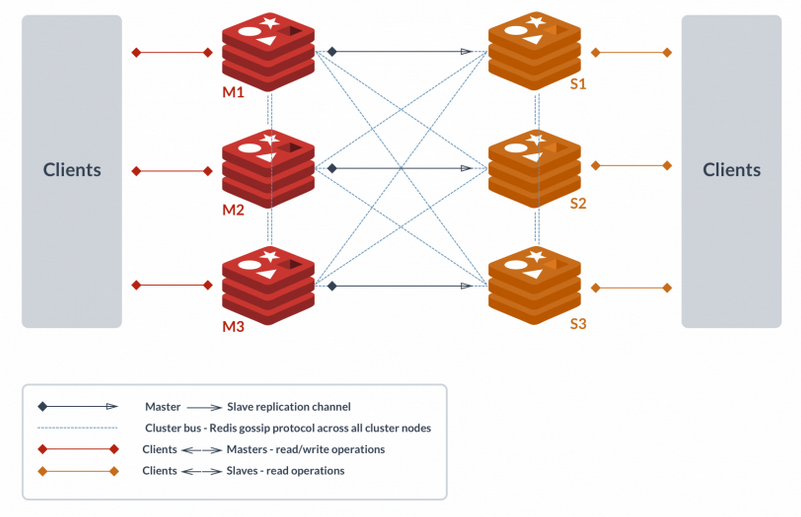
Redis 集群的工作原理
在 Redis 集群中,每个节点都打开两个 TCP 连接:
- 常规端口:用于客户端通信(例如 6379)。该连接对所有客户端以及需要使用客户端连接进行键迁移的集群节点均开放。
- 集群总线端口:用于其他集群节点之间的故障检测、配置更新和故障转移授权。该通道采用二进制协议传输数据,占用带宽更少。此端口始终为“常规端口 + 10000”。因此,若常规端口为 6379,则集群总线端口为 16379。
哈希槽(Hash Slots)
Redis 集群使用哈希槽来实现数据分片。一个 Redis 集群共有 16,384 个哈希槽。这些槽被分配给各个服务器。例如,若集群中有 3 个服务器,则可能如下分配:
- 服务器 A 拥有哈希槽 0 到 5,500。
- 服务器 B 拥有哈希槽 5,501 到 11,000。
- 服务器 C 拥有哈希槽 11,001 到 16,383。
哈希槽无需在各服务器间平均分配。
当新增或删除服务器时,这些哈希槽会自动重新分配。在不中断服务的前提下,即可完成哈希槽的迁移。因此,添加或移除节点,或调整节点持有的哈希槽比例,均无需停机。
当向 Redis 插入一个键时,系统通过 CRC-16 哈希函数将键转换为整数,再对该整数取模 16383,从而确定该键所属的哈希槽:
1HASH_SLOT = CRC16(key) mod 16383
哈希标签(Hash Tags)
Redis 集群支持跨多个键的操作,前提是这些键位于同一节点且属于同一个哈希槽。用户可通过使用哈希标签强制让多个键落入相同的哈希槽。
在哈希标签中,将一个子字符串置于键中的 {} 内。系统将基于该子字符串计算哈希值,因此所有包含相同标签的键将映射到相同的哈希槽。例如,假设我们要存储若干键并希望它们落在同一节点上,可在键中插入一个随机子字符串(如 abcd),例如:23464{abcd}2344、relat{abcd}ed、pre34{abcd}pared。当这些键被插入时,系统会以 abcd 作为哈希依据,因此所有键都将分配到相同的哈希槽。
Redis 集群的容错机制
单纯的数据分片无法应对服务器宕机的情况。一旦某台服务器崩溃,其上存储的所有键值数据将永久丢失。为解决此类问题,必须引入复制机制。Redis 集群采用主从模型,每个哈希槽可拥有 1 个(主节点自身)至 N 个副本(N-1 个从节点)。一个健康的集群至少应包含三个主节点,且每个主节点至少有一个从节点。因此,集群至少需要 6 个节点:M1、M2、M3 为主节点,S1、S2、S3 为对应的从节点。
Redis 集群采用异步方式将数据写入从节点。这意味着当键被插入或更新时,主节点会将变更信息发送给从节点,但不会等待确认。如果主节点崩溃,从节点可能尚未同步全部数据,导致部分数据丢失。虽然可以通过同步写入从节点来避免此问题,但这会显著降低性能。因此,Redis 集群在性能与一致性之间做出了权衡。
Redis 集群配置
默认情况下,Redis 以单实例模式运行。若需启用集群模式,需在 redis.conf 文件中配置一组新的指令,具体说明如下:
-
cluster-enabled:若需启动集群模式,此项应设为 yes。若设为 no,则该实例无法加入 Redis 集群。 -
cluster-config-file:指定用于存储集群状态变更的配置文件路径。该文件由 Redis 自动生成,用户不应手动修改。它记录了集群中节点数量、节点状态等信息。集群启动时会读取此文件。 -
cluster-node-timeout:定义节点在未响应情况下的最大超时时间(单位:毫秒)。若主节点在超过该时间后仍不可达,则其从节点将被提升为新主节点。若从节点不可达,则停止接收客户端请求。 -
cluster-slave-validity-factor:当主节点与从节点断开连接时,从节点会尝试发起故障转移。若该值为 0,则无论断连时间多长,从节点都会尝试接管主节点角色。
然而,可能存在主节点长时间断连,导致从节点数据过旧,不再适合作为主节点的情况。该属性用于计算允许的最大断连时间:
1最大时间 = cluster-node-timeout × cluster-slave-validity-factor
例如,若 cluster-node-timeout 为 2,cluster-slave-validity-factor 为 10,则最大允许断连时间为 20 毫秒。若从节点断连超过 20 毫秒,将被视为不合规,无法被提升为主节点。
-
cluster-migration-barrier:该指令定义主节点在仍有足够从节点连接时,不得触发从其他主节点迁移从节点的最低从节点数量。例如,有两个主节点 A 和 B,A 有两个从节点 A1 和 A2,B 有一个从节点 B1。若主节点 B 崩溃,B1 将被提升为主节点。此时 B 已无从节点。若cluster-migration-barrier设置为 2,则即使 A 有空闲从节点,B1 也无法从 A 借用从节点,因为不满足最低 2 个从节点的要求。 -
cluster-require-full-coverage:若某个主节点失败且没有从节点可用,则该主节点上的所有数据将丢失。若此项设为 yes(默认值),则整个集群将进入不可用状态。若设为 no,集群仍可继续处理查询请求,但丢失的数据将返回错误。