


导入
简介
通过Kaggle端到端案例拆解机器学习项目的关键步骤与业务目标
一个数据集与一个机器学习问题,你应该怎么做?
假设你最近被聘为数据科学家,参与一个项目,并获得了房地产相关数据。你该如何以一种系统化且结构化的方式来处理问题,而不是最终写出一团乱麻的代码?应该遵循哪些步骤?
在本节中,我们将通过一个真实的端到端示例(附带代码)来拆解开展机器学习项目所需的关键步骤。我们将基于一个Kaggle竞赛中的挑战进行实践。
主要步骤概览:
并没有一种适用于所有项目的“黄金法则”要求每位数据科学家都必须遵循。然而,领域内资深专家们推荐的一些良好实践和步骤值得牢记。对于本项目,我们将采用一种结合了多本著作、文章中的建议以及个人经验的综合方法(详情见“学习资料”部分)。
当然,这仅作为指导项目推进的参考框架,你可以根据具体项目需求增删步骤。
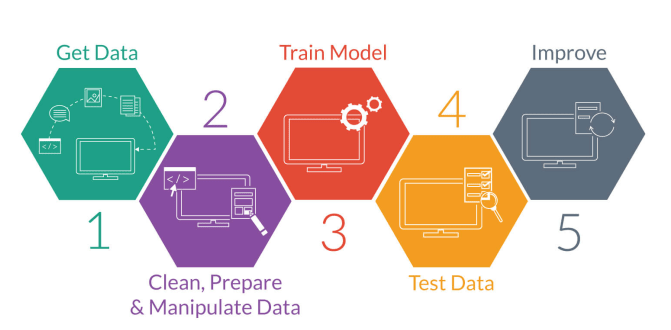
steps.png
以下是我们将依次完成的主要步骤:
1. 探索性数据分析
- 理解数据结构
- 发现并可视化数据,获取洞察
- 分析数值型特征
- 寻找数值特征之间的相关性
- 分析类别型特征
2. 为机器学习算法准备数据
- 处理缺失值
- 处理异常值
- 处理相关特征
- 处理文本和类别型特征
- 特征缩放
3. Scikit-Learn中的转换流水线
4. 评估机器学习算法
- 在训练集上训练并评估多个模型
- 对比分析各模型及其误差
- 使用交叉验证进行评估
5. 模型调优
6. 展示解决方案
7. 部署、监控与维护系统
重要前置步骤
在开始编码和随意操作数据之前,如果你面对的是一个真实的问题,你的第一个问题应该是向项目经理、利益相关方或项目负责人明确:业务目标到底是什么?仅仅构建一个机器学习模型并不是最终目的,他们更关心解决方案带来的实际价值。因此,你需要弄清楚公司期望如何使用你的工作成果,以及能从中获得哪些收益。
为什么这是真实项目中至关重要的一步?
因为清晰理解业务目标将决定:
- 如何定义问题本身
- 选择何种算法
- 采用何种性能指标来评估模型
- 在优化最终模型上投入多少精力
- 如何呈现你的解决方案
什么是问题定义?
这意味着你需要首先判断自己面对的是监督学习、无监督学习还是强化学习?你被分配的任务是分类、回归,还是其他类型?