


项目创建:第一部分(项目介绍)
在本节课中,我们将基于自然语言处理中的迁移学习,开始构建本课程的最后一个项目。
项目简介
到目前为止,我们已经讨论了多种主题。还记得之前关于迁移学习和 word2vec 的内容吗?在本项目中,我们将使用另一种预训练模型(词嵌入):GloVe。该项目将综合运用迁移学习、词嵌入和LSTM的相关概念,目标是根据给定的句子预测对应的表情符号(emoji)。
要开始这个项目,你需要安装以下依赖包。请先确保它们已正确安装,可以在本地运行如下命令:
1pip install emoji
2pip install numpy
3pip install pandas
4pip install keras
导入包并加载数据集
你可以通过点击下方的下载按钮获取数据文件。该数据集非常小,这正是我们在本项目中使用迁移学习的主要原因。获得数据集后,即可按如下方式导入所需包。
1import numpy as np
2import pandas as pd
3import emoji as emoji
4print('导入成功!')
Emoji 包介绍
在正式开始项目前,我们先了解一下即将使用的 emoji 包。
1print(emoji.EMOJI_UNICODE)
2print(len(emoji.EMOJI_UNICODE))
运行上述代码后,你会得到一个字典,其中键为表情符号的短名称(shortcode),值为对应的 Unicode 表情字符。可以看到,当前共有约 3800 个表情符号可供使用。
但在本项目中,我们仅使用以下五个表情符号:
1emoji_dictionary = {"0": "\u2764\uFE0F",
2                    "1": ":baseball:",
3                    "2": ":beaming_face_with_smiling_eyes:",
4                    "3": ":downcast_face_with_sweat:",
5                    "4": ":fork_and_knife:",
6                   }
7for e in emoji_dictionary.values():
8  print(emoji.emojize(e))
说明:
- 第1行:定义了项目中要用到的表情符号及其对应的 Unicode 编码。
- 第7行:使用 for 循环结合
emojize()方法显示这些表情符号。
数据探索
现在我们使用刚才创建的字典来查看数据集内容。
1# 加载训练集和测试集
2train = pd.read_csv('dataset/train_emoji.csv',header=None)
3test = pd.read_csv('dataset/test_emoji.csv',header=None)
4
5data = train.values
6for i in range(10):
7    print(data[i][0],emoji.emojize(emoji_dictionary[str(data[i][1])]))
说明:
- 第5行:将 DataFrame 对象转换为 NumPy 数组。
- 第6–7行:通过循环打印前10条句子及其对应的表情符号。
GloVe 词嵌入
在完成数据探索并准备好环境后,接下来了解 GloVe 词嵌入。GloVe 是“Global Vectors for Word Representation”的缩写,由斯坦福大学开发,是一种用于生成词语向量表示的无监督学习算法。
接下来我们将构建一个词到向量的映射字典。在此之前,请先下载 GloVe 向量文件,大小约为 150 MB,提供每个词的 50 维向量表示,训练语料规模约 60 亿词元。你也可以选择在 Google Colab 中使用更高维度的向量,就像我们在 word2vec 示例中所做的那样。
在 Colab 中运行以下命令:
1!wget  "http://nlp.stanford.edu/data/glove.6B.zip"
2!unzip "glove.6B.zip"
解压后你会看到四个文本文件,分别包含 50、100、200 和 300 维的 GloVe 向量。本项目将使用 50 维向量,但你也可以尝试其他维度。
加载 GloVe 词嵌入
现在我们加载词嵌入,并尝试获取一些词语的向量表示。
1embeddings = {}
2with open('glove.6B.50d.txt',encoding='utf-8') as f:
3    for line in f:
4        values = line.split()
5        word = values[0]
6        coeffs = np.asarray(values[1:],dtype='float32')
7        embeddings[word] = coeffs
8
9print(embeddings['eat'])
10print(embeddings['play'])
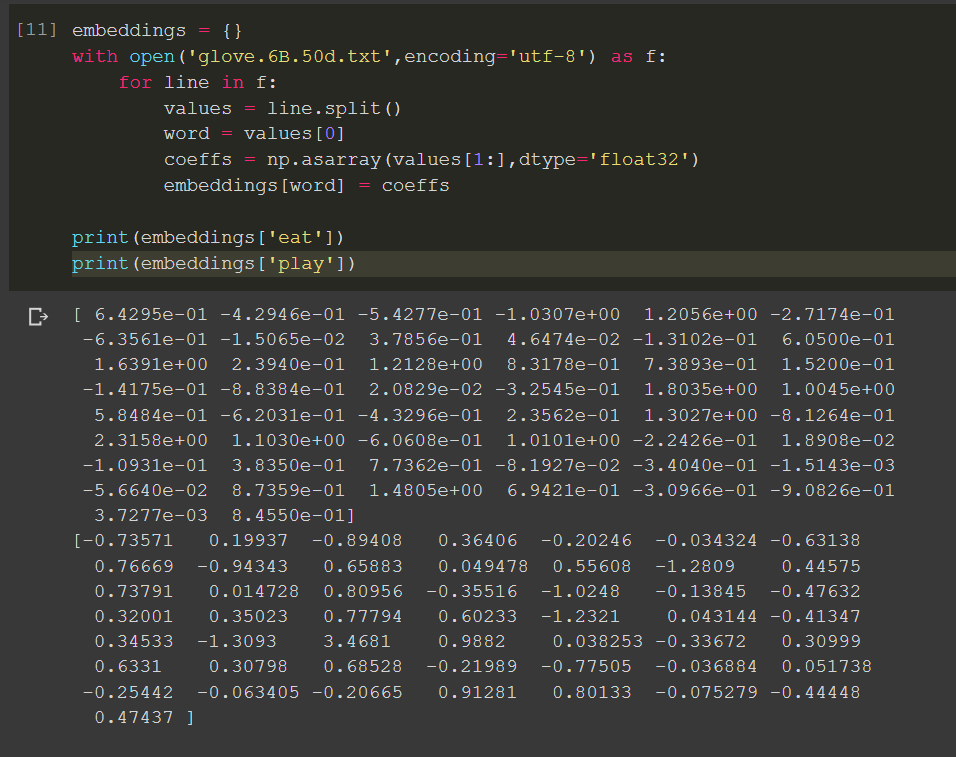
说明:
- 第1行:创建一个字典,用于存储单词及其对应的向量(以键值对形式)。
- 打开
glove.6B.50d.txt文件可发现,每行的第一个元素是单词,其余部分为向量数值。 - 第5行:提取每一行中的单词。
- 第6行:提取该行中除单词外的所有数值,并将其转换为 float32 类型的 NumPy 数组。
- 第7行:将单词及其向量作为键值对存入字典。
- 第9–10行:查看特定单词(如 'eat' 和 'play')的向量表示。可以看出,每个向量长度为 50。
但是等等!我们的数据集中是完整的句子,那该如何为整个句子生成一个向量呢?