


GPU - 图形处理单元
认识 GPU、GPGPU、CUDA 与 Tesla 的架构和内存结构
GPU 这一术语由英伟达(nVIDIA)在1999年推广,该公司将一款名为 GeForce 256 的计算机图形卡宣传为“全球首款 GPU”。然而,这款显卡最初主要面向高端计算机图形渲染,并用于提升基于计算机的游戏性能。相比之下,如今的 GPU 还为开发和运行高性能非图形类应用提供了一个成本低廉的平台。在 GPU 上开发通用应用程序的技术通常被称为 GPGPU(基于 GPU 的通用计算),目前已有多个公司开始生产具备通用计算能力的 GPU。
在各类 GPU 中,我们特别选择了英伟达的 Tesla 平台作为典型代表。尽管最新的 GPU 如 Fermi、Kepler(如 Tesla K80)、Pascal、Volta 在具体实现上略有不同,但其基本架构原理相似。这些设备均支持使用一种易于编程的类 C 语言——统一计算设备架构(CUDA),供开发者编写应用程序。
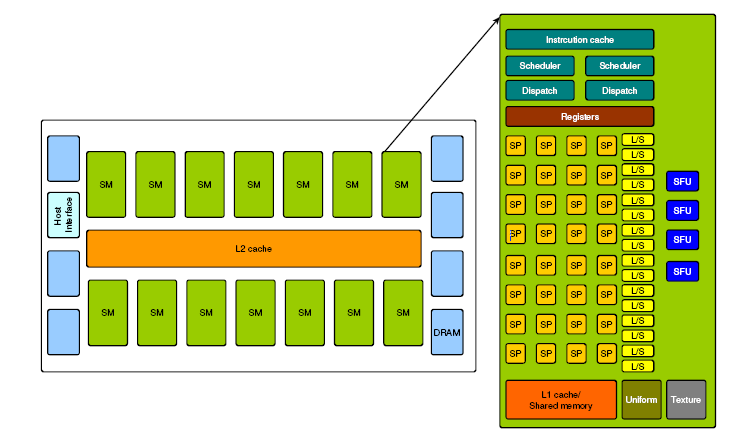
上图展示的是 Tesla 统一 GPU 架构的示意图,描述了 Tesla C2050 设备的整体框架。该设备共包含 448 个 流处理器(SP) 核心,按每组 32 个核心划分为 14 个 流多处理器(SM)。每个核心以所谓的 SIMT(单指令多线程) 方式执行顺序线程,同一组中的所有线程同时执行相同的指令,其中一组称为一个 线程束(warp),包含 32 个线程。每个 SM 最多可同时运行 32 个活跃线程束。当某个线程束在条件操作中发生阻塞时,系统会自动切换到另一个就绪的线程束,以保持核心持续工作。
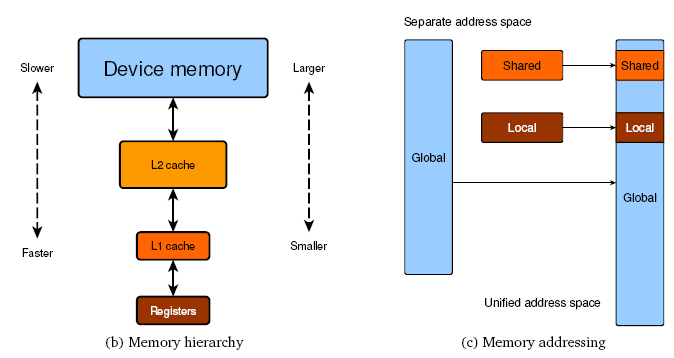
与其它 GPU 类似,Tesla 设备具有多层次的板载内存结构,包括高速且可编程的小容量 L1 缓存/共享内存(16–48 KB)、完全一致的 L2 缓存(512–768 KB),以及容量较大的板载 DRAM 或设备 主内存(3–6 GB)。L1 缓存与每个流多处理器相连,并由该 SM 内的多个核心共享;而统一的 L2 缓存则在整个设备范围内共享。L2 缓存的主要作用是降低设备 DRAM 长延迟带来的影响。此外,每个 SM 内还包含一些寄存器文件(128 KB)、纹理缓存和常量缓存。在软件层面,所有这些内存层级被统一映射为一个连续的地址空间。
目前存在多种应用程序编程接口(API),可帮助程序员访问设备内存并开发基于 GPU 的应用程序。