


简介
本课程介绍并发编程,并提供一些动机性示例,以帮助我们更好地理解并发系统。
简介
对并发及其使用线程或协程实现模型的理解,体现了候选人的成熟度和技术深度,这在争取更高层级的职位 offer 时可能成为重要区分点。更重要的是,掌握并发机制使我们能够编写高性能且高效的程序。事实上,在处理任何规模较大的项目时,你不可避免地会深入到并发的核心问题。
我们将从线程开始,因为它们是并发领域中最广为人知和最熟悉的概念。线程并非物理实体,就像大多数计算机科学概念一样。线程最接近实际可见的表现形式出现在调试器中。下图展示了一个示例程序在调试器中暂停时的线程状态。
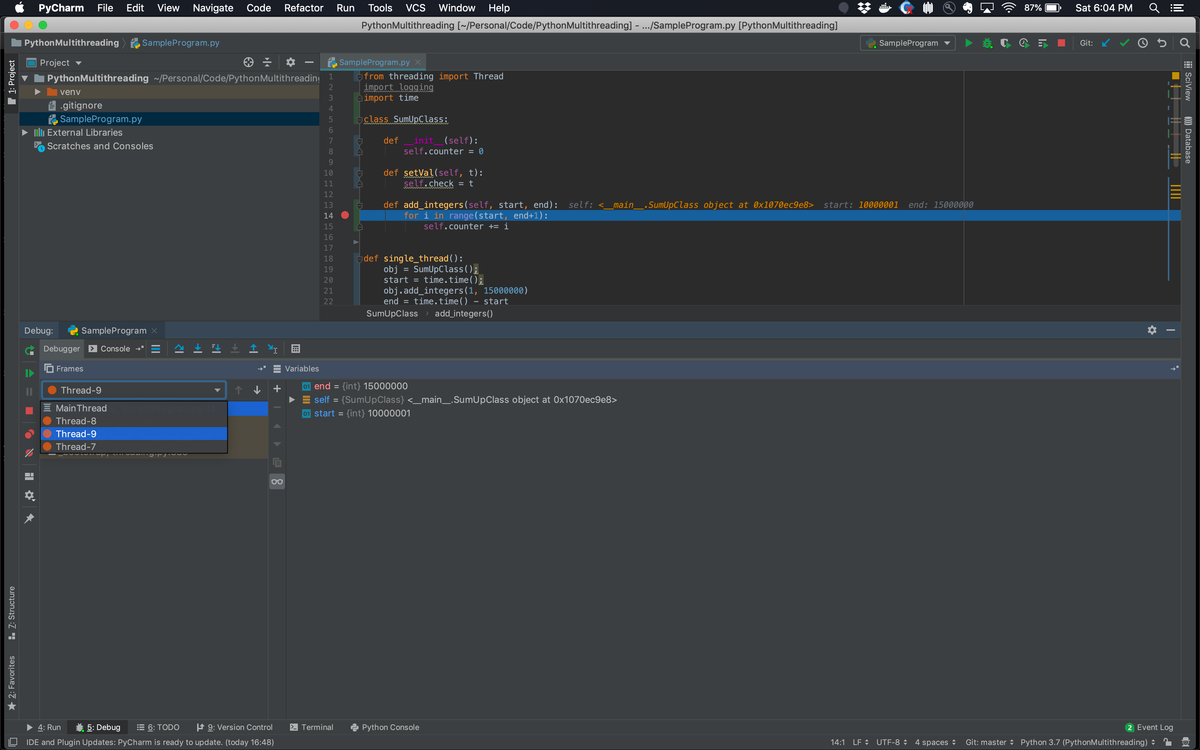
一个最简单的并发系统示例,是一台单处理器机器上运行你最喜欢的 IDE。假设你编辑某个代码文件并点击保存。这个按钮点击操作将触发一个工作流程,导致数据被写入底层物理磁盘。然而,I/O 操作代价高昂,CPU 在数据写入磁盘期间将处于空闲状态。
在 I/O 操作进行时,空闲的 CPU 可以去执行其他有用的任务。这时就轮到线程登场了——I/O 线程被 切换出去,UI 线程被调度到 CPU 上运行,这样当你在屏幕上点击其他位置时,IDE 依然保持响应,不会显得卡顿或冻结。
线程可以在单个 CPU 上制造出多任务并行的假象,尽管实际上 CPU 在任意时刻只执行一个线程。每个线程获得一段 CPU 时间片,然后被切换出去,原因可能是它启动了一个需要等待、不占用 CPU 的任务,或者已经用完了分配的时间片。虽然线程调度的具体机制有很多细节和复杂性,但上述描述构成了其基本原理。
随着硬件技术的进步,如今多核机器已很常见。应用程序可以利用这种架构,让每个线程由独立的 CPU 核心运行。然而,正如本课程后续将要讲解的,标准版本的 Python 在运行多线程程序时,无法有效利用系统中的多个处理器。
线程的优势
更高的吞吐量,尽管在某些极端情况下,线程之间的上下文切换开销可能会抵消性能提升,甚至导致性能低于单线程场景。但这种情况较为罕见,属于例外而非普遍现象。此外,多线程程序可以利用多核处理器,而单线程程序即使有多个核心可用,也仅能使用其中一个。
响应式应用,在单核机器上营造出多任务并行的假象。
资源利用更高效。请注意,相比创建全新的进程,线程的创建开销要轻得多。使用线程而非为每个请求创建新进程的 Web 服务器,消耗的资源更少。此外,同一进程内的所有线程共享相同的地址空间,因此无需像进程之间那样依赖共享内存。
多线程的其他所有优势,都是上述几点的延伸或间接结果。
多线程带来的性能提升
以一个具体例子说明:下面的代码任务是 计算从 1 到 30,000,000(3000 万)所有整数的总和。第一种情况是单线程完成求和;第二种情况是将范围分为两部分,由两个线程分别求和,待两个线程完成后,将两个半段结果相加得到最终总和。最后,我们改用进程来重复该过程。我们测量每种方案所花费的时间并输出结果。
1from threading import Thread
2from multiprocessing import Process
3
4from multiprocessing.managers import BaseManager
5from queue import Queue
6import time
7import multiprocessing
8
9
10class SumUpClass:
11
12    def __init__(self):
13        self.counter = 0
14
15    def add_integers(self, start, end):
16        for i in range(start, end + 1):
17            self.counter += i
18
19    def get_counter(self):
20        return self.counter
21
22
23def single_thread():
24    obj = SumUpClass();
25    start = time.time();
26    obj.add_integers(1, 30000000)
27    end = time.time() - start
28    print("单线程耗时 : {} 秒,总和为 {}".format(end, obj.counter))
29
30
31def multiple_threads():
32    obj1 = SumUpClass()
33    obj2 = SumUpClass()
34    start = time.time()
35
36    t1 = Thread(target=obj1.add_integers, args=(1, 15000000,))
37    t2 = Thread(target=obj2.add_integers, args=(15000001, 30000000))
38
39    t1.start()
40    t2.start()
41
42    t1.join()
43    t2.join()
44    combined_sum = obj1.counter + obj2.counter
45    end = time.time() - start
46    print("多线程耗时 : {} 秒,总和为 {}".format(end, combined_sum))
47
48
49def single_process(obj1, start, end):
50    obj1.add_integers(start, end)
51
52def multiple_processes():
53    BaseManager.register('SumUpClass', SumUpClass)
54    manager = BaseManager(address=('127.0.0.1', 63333))
55    manager.start()
56
57    obj1 = manager.SumUpClass()
58    obj2 = manager.SumUpClass()
59    start = time.time()
60
61    p1 = Process(target=single_process, args=(obj1, 1, 15000000,))
62    p2 = Process(target=single_process, args=(obj2, 15000001, 30000000,))
63
64    p1.start()
65    p2.start()
66
67    p1.join()
68    p2.join()
69
70    combined_sum = obj1.get_counter() + obj2.get_counter()
71    end = time.time() - start
72    print("多进程耗时 : {} 秒,总和为 {}".format(end, combined_sum))
73    manager.shutdown()
74
75if __name__ == "__main__":
76    print("系统共有 {0} 个 CPU".format(multiprocessing.cpu_count()))
77    single_thread()
78    multiple_threads()
79    multiple_processes()
下表展示了不同方案计算从 1 到 3000 万整数之和所需的时间(单位:秒)。
| 配置 | 时间 (秒) |
|---|---|
单线程 | 9.9 |
多线程 | 12.3 |
多进程 | 13.1 |
结果令人意外且反直觉。我们本预期多线程方案应优于单线程,因为如果系统至少有两个 CPU,两个线程可以并行运行。然而,与单线程相比,多线程表现较差,这可以用(标准)Python 的致命弱点——全局解释器锁(GIL)来解释。GIL 是 Python 运行时环境中的一个机制,即使存在多个空闲 CPU,也只允许一个线程同时执行。我们将在后续章节中深入讨论这一问题。对于像本例中这样的 CPU 密集型任务,多线程无法实现真正的并行执行,反而因额外的管理开销和结果合并成本,导致性能不如单线程。
使用多进程时,理论上每个进程可被调度到不同的 CPU 上并行运行。但创建和销毁进程的开销远高于线程。此外,我们使用了 Python 的进程间通信机制,该机制基于代理模式,引入了网络延迟。这些因素共同导致多进程方案的性能并未优于单线程。
然而,在涉及阻塞操作(如网络请求、磁盘 I/O)的一般任务中,迁移到多线程或多进程架构通常能带来显著的性能提升。
线程的问题
世上没有免费的午餐。使用线程的代价体现在以下几个方面:
- 调试困难,一些错误可能仅在生产环境中出现。由于线程执行顺序不确定,这类 bug 很难复现。
- 代码维护成本高,因为并发代码本身更难以理解和推理。
- 系统资源消耗增加。每个线程的创建都会占用额外内存,消耗 CPU 周期用于管理,并造成上下文切换的时间浪费。
- 程序可能出现性能下降,线程间的协调需要付出代价。获取和释放锁会增加执行时间,多个线程争抢锁则会导致锁竞争。
在上述背景下,我们进一步深入探讨并发编程的细节,这些内容很可能成为面试中的考察重点。