


导入
简介
使用 TensorFlow 和协议缓冲区构建高效数据输入流水线
在本课程章节中,你将使用 TensorFlow 来加载和存储数据。具体来说,你将使用协议缓冲区(protocol buffers)高效地存储大量数据,然后利用 TensorFlow 的 tf.data API 来加载这些数据。我们将使用一个包含大学生信息的数据集来测试你的代码。
A. 输入流水线
机器学习模型几乎总是使用极其庞大的数据集进行训练。根据应用场景的不同,一个训练数据集可能包含数十万甚至数百万个样本。由于数据集规模巨大,以高效的方式存储数据变得至关重要。
从文件中加载数据并将其输入到机器学习模型中的过程被称为输入流水线(input pipeline)。由于输入流水线负责处理机器学习项目中的大量数据,因此必须尽可能高效。
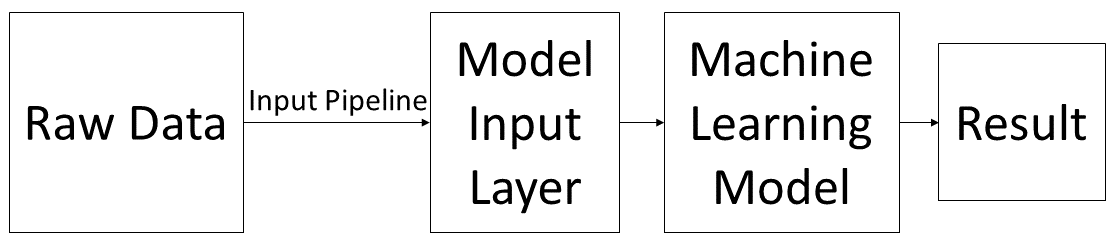
机器学习模型的输入流水线
一种灵活且高效的大量数据存储格式是 Google 提出的协议缓冲区。协议缓冲区类似于 JSON 和 XML(另一种基于特征的数据格式),但占用空间更小,处理速度更快。当与 TensorFlow 结合使用时,协议缓冲区能够显著简化大规模数据集的输入流水线。
B. 加载数据
协议缓冲区能与 TensorFlow 良好协作的一个主要原因是,它们可以非常方便地作为输入加载进机器学习模型。由于 TensorFlow 同样由 Google 开发,其 API 中提供了可以直接快速读取协议缓冲区数据的函数。正因如此,大多数官方的 TensorFlow 开源模型都采用协议缓冲区来存储和加载数据。
特别是 tf.data API,为我们提供了构建高效输入流水线所需的全部工具。它不仅与协议缓冲区(用于存储基于特征的数据)配合良好,也能有效处理 NumPy 数据。在接下来的章节中,你将分别使用协议缓冲区和 NumPy 数据创建输入流水线。