


概率分布函数
在本节课中,我们将首先概述概率分布函数,然后讨论连续分布。
我们在这门课程中主要关注的是小型离散分布,但我们在本系列的开头曾探讨过连续分布。现在,我们已经对如何解决简单离散分布和马尔可夫过程中的概率问题有了一定的理解,让我们重新回到连续分布,并尝试将这些知识应用到它们身上。
什么是概率分布函数?
让我们从基础开始。我们所说的概率分布函数到底是什么意思?到目前为止,在这门课程中,我们主要讨论的是其离散版本——非归一化的概率质量函数。也就是说,对于一个 IDiscreteDistribution<T>,我们有一个权重函数,为每个 T 值赋予一个数值。抽样得到某个特定 T 的概率,就是该值的权重除以所有 T 权重的总和。
当然,如果我们选择使用浮点数作为权重而非整数,就可以得到一个归一化的概率质量函数:即每个 T 的“权重”会自动除以总权重,直接得到概率值。在这种情况下,所有权重之和等于 。
通过我们对加权整数分布的探索可以知道,我们可以把概率分布看作是一个矩形,其中不同的子矩形对应于不同的取值;然后我们“投掷飞镖”到这个矩形上进行采样,飞镖落点的位置就决定了我们获得的样本值。
在接下来的课程中,我们将用 PDF 来简写“概率分布函数”。
连续分布
连续分布也可以用类似的方式来理解。假设我们有一个从 double 到 double 的函数,始终非负,且整个曲线下的总面积为 。以下是一些例子:
1double PDF1(double x) => x < 0.0 | x >= 1.0 ? 0.0 : 1.0;
2double PDF2(double x) => x < 0.0 | x >= 1.0 ? 0.0 : 2 * x;
3double PDF3(double x) => Exp(–(x * x)) / Sqrt(PI);
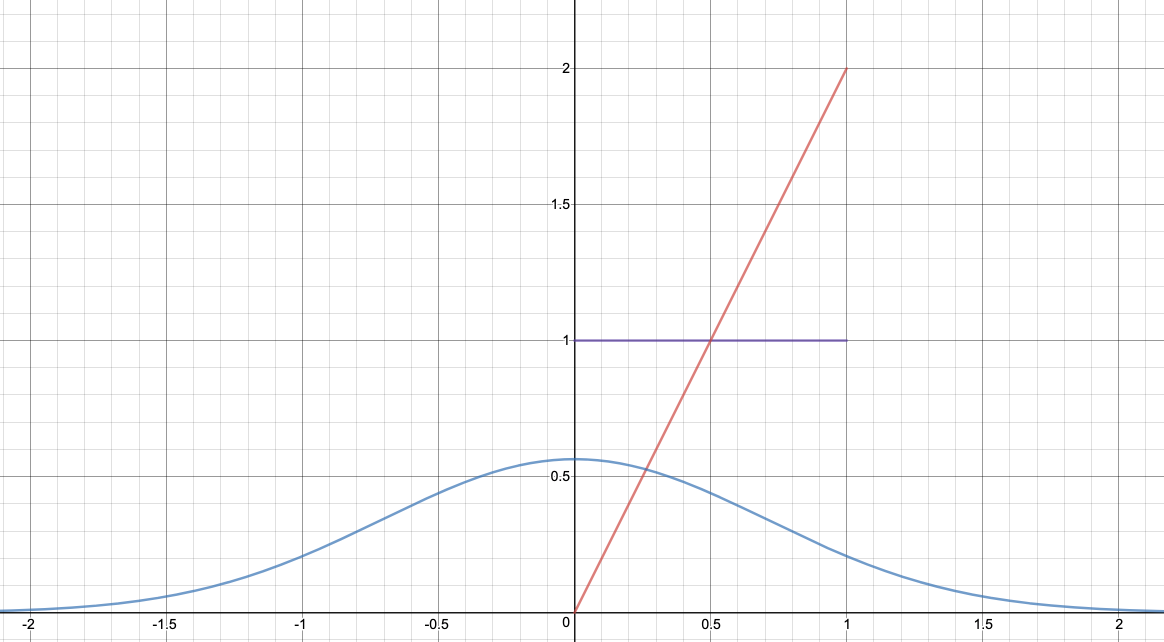
这些函数作为概率分布意味着什么?显然,函数值越高,对应的取值就越“可能”,但究竟如何理解在 PDF2 和 PDF3 中, 比 “更不可能”,而在 PDF1 中两者却“同样可能”呢?
一种理解方式是:再次想象我们“投掷飞镖”到曲线下的区域。对于任意一个子区域,飞镖落在该区域内的概率与该区域的面积成正比,而采样的值就是飞镖落点的 坐标。
我们可以稍微形式化一点,将区域限制为极小的矩形:
- 取一个值,比如 。
- 再取一个很小的偏移量 (只要足够小即可)。
- 抽样结果落在 到 之间的概率约为 ,也就是一个细长矩形的面积。
就是这样!假设我们有两个值 和 ,,来看看这三个分布在这两个值附近的概率情况:
- 对于
PDF1,落在 到 的概率约为 ,落在 到 的概率也约为 。 - 对于
PDF2,落在 到 的概率约为 ,落在 到 的概率约为 。 - 对于
PDF3,落在 到 的概率约为 ,落在 到 的概率约为 。
而且,随着 越来越小,这个近似效果越好。
如果我们想知道两个不“非常接近”的浮点数之间取值的概率怎么办?这时我们可以采用“数值积分”方法:将区间划分为许多极小的部分,分别计算每个小区间的面积并求和,从而近似总面积。或者,我们可以使用积分微积分来求得精确解。但在本课程中,我们将尝试寻找无需进行数值积分近似或积分计算的方法,直接从具有特定 PDF 的分布中进行采样。
好了,我们已经理解了 PDF 是什么。总结如下:
- PDF 是一个从
double到double的纯函数。 - PDF 定义在整个实数范围内。
- 对所有 ,都有 。
- 对整个实数轴积分后,总面积为 。
- 当 很小时,样本落在 到 之间的概率约为 。
对于我们的用途,我们假设一个“非归一化”的 PDF 具备以下性质:
- PDF 是一个从
T到double的纯函数。 - 定义在
T的整个取值范围内。 - 对所有 ,都有 。
- 对所有可能的
T值积分后,总面积为某个有限正数 。也就是说,分布不一定归一化为面积 。(你可能会认为只需将每个权重除以 就能归一化,但很多时候我们并不容易知道这个面积是多少。) - 当 很小时,样本落在 附近 范围内的概率约为 。
补充说明:最后一句话略显模糊——如果 不是
double类型,“在 范围内”具体指什么?我们暂时不必深究这个问题。它不会造成困扰。特别是因为我们大多数情况下处理的T本身就是double。
这在多维情形下尤其有用,例如当 T 是 (double, double) 类型时,“在 范围内”可能表示“位于边长为 的正方形内”之类的情况。要将这一切建立在严格的数学基础上,会偏离主题太远;但你已经明白了核心思想,我们继续前进。
在类型系统中定义接口
正如我们将看到的,连续分布比之前讨论的小型离散分布更难处理。不过,我们仍然可以做一些事情。让我们先在类型系统中为具有上述宽松 PDF 的分布定义一个接口:
1public interface IWeightedDistribution<T> : IDistribution<T>
2{
3  double Weight(T t);
4}
这意味着每一个离散分布都可以被视为一个加权分布。我们来实现这一点:
1public interface IDiscreteDistribution<T> : IWeightedDistribution<T>
2{
3  IEnumerable<T> Support();
4  new int Weight(T t);
5}
现在我们需要支付一些小代价:需要在所有现有的离散分布中添加如下代码:
1double IWeightedDistribution<T>.Weight(T t) => this.Weight(t);
但这很容易完成。
我们还可以回到 Normal 类中补充权重函数:
1private static readonly double piroot = 1.0 / Sqrt(2 * PI);
2public double Weight(double x) =>
3  Exp(–(x – μ) * (x – μ) / (2 * σ * σ)) * piroot / σ;
以及 StandardContinuousUniform 类:
1public double Weight(double x) =>
2  0.0 <= x & x < 1.0 ? 1.0 : 0.0;
我们引入了一种新的分布加权概念,看看能走多远。
实现
现在来看本课的代码:
1using System;
2
3namespace Probability
4{
5    class Program
6    {
7        static void Main()
8        {
9            Console.WriteLine("Probability");
10            Episode25.DoIt();
11        }
12    }
13}
我们已经知道如何高效地从任意小型离散分布(整数权重)中采样,但基于任意 PDF 的分布则要难对付得多。给定一个任意的非归一化 PDF,我们能否从中进行采样?