


数据集
了解 Spark 中提供的强类型数据集 API 的入门知识。
数据集(Datasets)
以下是来自官方 Databricks 文档中对 Dataset 的定义:
"数据集是一种强类型、不可变的对象集合,其映射到关系型模式。数据集是 Java 和 Scala 等静态类型语言中可用的类型安全结构化 API,仅限于 JVM 语言。由于 R 和 Python 是动态类型语言,因此不支持数据集。"
自 Spark 2.0 以来,RDD 被 Dataset 取代。Dataset 与 RDD 类似,具有强类型特性,但在底层拥有更丰富的优化机制。
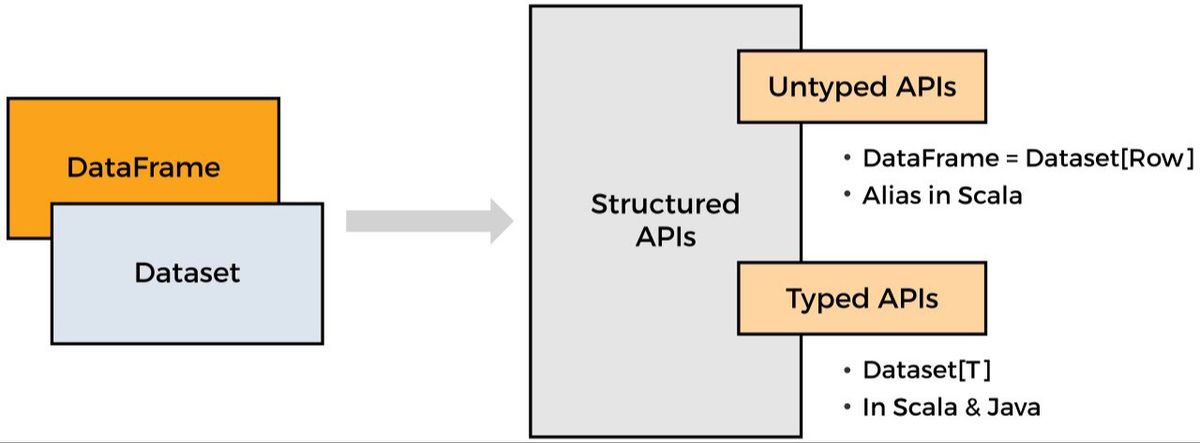
在 Scala 环境中,可以将 DataFrame 视作 Dataset[Row] 类型的通用对象集合的别名。Row 对象是无类型的,是一个可容纳多种字段类型的通用 JVM 对象。相比之下,Dataset 是 Scala 中强类型的 JVM 对象集合,或 Java 中的类集合。可以说,每个 Scala 中的 Dataset 都有一个称为 DataFrame 的无类型视图,即 Row 类型的 Dataset。下表总结了不同 Spark 支持语言中 Dataset 与 DataFrame 的概念差异。
| 语言 | 强类型与无类型的主要抽象 | 是否支持强类型 |
|---|---|---|
| Scala | Dataset[T] 与 DataFrame | 同时支持强类型和无类型 |
| Java | Dataset | 强类型 |
| Python | DataFrame | 无类型(使用通用 Row) |
| R | DataFrame | 无类型(使用通用 Row) |
Dataset 的实现依赖于一个名为 编码器(encoder) 的特性,它负责将 JVM 类型转换为 Spark SQL 的专用内部(表格)表示形式。编码器是高度专业化且经过优化的代码生成器,会为数据的序列化和反序列化生成定制化的字节码。所有 Dataset 都需要编码器。编码器将特定领域的类型映射到 Spark 内部对应的数据类型表示。例如,Row 中的一个 Int 字段,在 Scala 或 Java 中会被映射为 IntegerType,在 Python 中则为 IntegerType()。特定领域的类型在 Java 中通常以 Bean 表示,在 Scala 中则以 case class 表示。这种表格化表示采用 Spark 内部的 Tungsten 二进制格式存储,支持对序列化数据的操作,并提升内存使用效率。当使用 Dataset API 时,Spark 会在运行时生成代码,将 Java 对象序列化为内部二进制结构,反之亦然。虽然这种转换可能带来轻微的性能开销,但带来的好处显著:Spark 能够理解 Dataset 中数据的结构,从而在缓存时创建更优的内存布局。
以下是一个在 Scala Shell 中实例化 Row 对象的示例,该对象是无类型的。随后尝试通过索引调用 getter 方法获取字段值。注意,若试图将字符串当作整数读取,或反之,则会触发类型转换异常。row 变量本身是一个无类型的通用对象。如果使用的是 Dataset,那么其中的每个元素都会对应一个 JVM 对象。
1scala> var row = Row("Upcoming New Movie", 2021, "Comedy")
2row: org.apache.spark.sql.Row = [Upcoming New Movie,2021,Comedy]
3
4scala> row.getInt(0)
5java.lang.ClassCastException: java.lang.String cannot be cast to java.lang.Integer
6  at scala.runtime.BoxesRunTime.unboxToInt(BoxesRunTime.java:103)
7  at org.apache.spark.sql.Row.getInt(Row.scala:245)
8  at org.apache.spark.sql.Row.getInt$(Row.scala:245)
9  at org.apache.spark.sql.catalyst.expressions.GenericRow.getInt(rows.scala:166)
10  ... 47 elided
11
12scala> row.getInt(1)
13res125: Int = 2021
14
15scala> row.getString(0)
16res126: String = Upcoming New Movie
17
18scala> row.getString(1)
19java.lang.ClassCastException: java.lang.Integer cannot be cast to java.lang.String
20  at org.apache.spark.sql.Row.getString(Row.scala:277)
21  at org.apache.spark.sql.Row.getString$(Row.scala:277)
22  at org.apache.spark.sql.catalyst.expressions.GenericRow.getString(rows.scala:166)
23  ... 47 elided
与 DataFrames 的区别
为了更好地理解两者,我们需要对比 Dataset 与 DataFrame。Dataset 在编译时检查类型是否符合规范,而 DataFrame 并非真正意义上的“无类型”——尽管其类型由 Spark 维护,但类型是否符合模式的验证是在运行时完成的。换句话说,DataFrame 可以看作是类型为 Row 的 Dataset,这是 Spark 用于计算的内部优化内存表示。通过使用自身的类型内部表示,Spark 可以跳过 JVM 类型的实例化过程,避免因频繁创建对象带来的性能损耗和垃圾回收开销。这一特性将在后续课程中深入探讨。
Dataset 的适用场景
尽管已有 DataFrame,但 Dataset 仍具有独特价值。在某些场景下,Dataset 比 DataFrame 更合适,因为某些操作无法通过 DataFrame 实现,只能通过 Dataset 完成。此外,类型安全性也是一大优势:例如,在代码中尝试将两个字符串变量相乘,会在编译阶段就报错,而非等到运行时才暴露问题。同时,开发体验也得到提升——IDE 和其他工具能够基于强类型提供自动补全和提示信息。另一个使用 Dataset 的理由是:当所有数据和转换逻辑都基于 case class(Scala)时,这些结构可轻松复用于分布式和本地计算任务中,无需额外转换。