


Spark SQL 引擎
了解 Spark SQL 引擎及其两个子组件:Tungsten 项目和 Catalyst 优化器。
概述
Spark SQL 允许开发者以编程方式对具有模式(schema)的结构化数据执行符合 ANSI SQL:2003 标准的查询。Spark SQL 自 1.3 版本起引入,此后在其基础上构建了多项高级功能,包括:
- 生成优化的查询计划,并最终执行紧凑的 JVM 代码。
- 作为与外部工具通过数据库 ODBC/JDBC 连接器进行交互的桥梁。
- 支持读写多种格式的结构化文件(如 JSON、CSV 或 Avro),并将其转换为临时表。
- 连接 Apache Hive 元存储(metastore)及表。
- 提供交互式 Spark SQL Shell,便于快速进行即席数据探索。
- 统一 Spark 的各个组件,支持在 Spark 所支持的语言(Java、Scala、Python 和 R)中创建 DataFrame/Dataset 抽象。
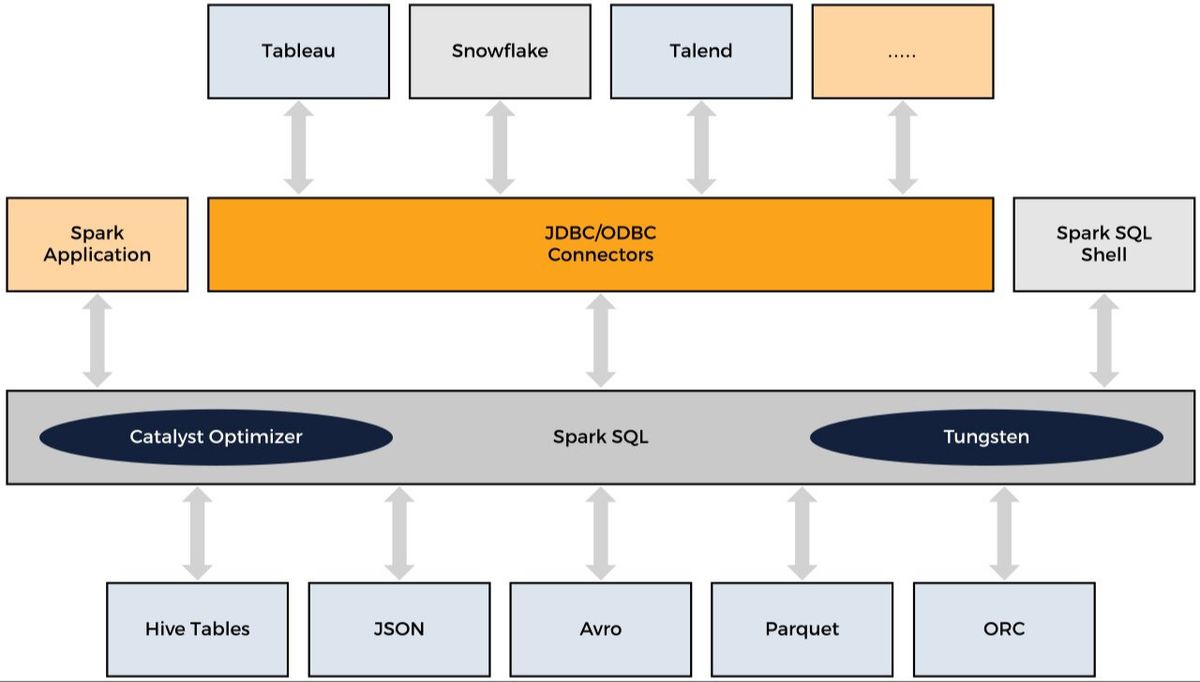
Spark SQL 的组成部分
Spark SQL 的核心由以下两个组件构成:
-
Tungsten 项目:包含一系列旨在提升 Spark 应用程序内存与 CPU 效率的改进措施。其一项关键特性是使用一种快速且紧凑的自定义格式来存储 DataFrame 和 Dataset,而非依赖占用更多内存且操作较慢的 JVM 对象。
-
Catalyst 优化器:接收一个计算查询,输出对应的执行计划。该过程包含四个转换阶段,简要说明如下:
-
分析阶段:解析 SQL 或 DataFrame 查询中引用的列名和表名,并生成查询的抽象语法树(AST)。此阶段会查询内部目录(catalog)以完成名称解析。目录是 Spark SQL 的程序化接口,用于维护列名、数据类型、函数、表、数据库等信息的列表。
-
逻辑优化阶段:在此阶段,采用基于规则的优化方法生成多个候选计划,并为每个计划分配成本评估。优化操作包括常量折叠、谓词下推、投影裁剪以及布尔表达式简化等。最终得到的逻辑计划将作为下一阶段的输入。
-
物理规划阶段:针对选定的逻辑计划生成具体的物理执行计划。
-
代码生成阶段:在最后阶段,为集群中每台机器生成 Java 字节码以供执行。Spark SQL 还可以处理已加载到内存中的数据集,并利用先进的编译技术进行代码生成,从而加速执行效率。在此阶段常提到“全代码生成”的概念,这是一种物理查询优化技术,它将整个查询合并为单一函数,消除虚函数调用,并利用 CPU 寄存器存储中间结果。Spark 2.0 随附的第二代 Tungsten 引擎采用了这一方法,显著提升了 CPU 性能与运行效率。
-
我们对 Spark SQL 引擎及其两大核心组件——Catalyst 优化器与 Tungsten——进行了高层次的概述。由于本课程范围有限,且对大多数 Spark 框架开发者或使用者而言,深入理解其具体技术实现并非必要,因此省略了相关细节的详细解释。