


K均值聚类
在本节课中,我们将介绍一种基于某些度量指标对项目进行分组的模型。
聚类是一种无监督的机器学习模型,它根据某种度量方式将相似的项目划分为若干组。当数据没有标签时,聚类是探索数据的一种常见方法。聚类本身并不是某一个具体的算法,而是一类需要解决的通用任务。不同的算法在“什么是簇”以及“如何高效地找到簇”方面存在显著差异,因此可以通过多种算法来实现聚类。
聚类是一类专注于将相似项目分组的算法。其中最著名的算法之一是 k-means。本节课我们将重点讲解该算法,并进行一些拓展讨论。
什么是 k-means
聚类是一个广泛的话题。k-means 是一种试图将数据点划分为 k 个组并最小化某个指标(称为惯性或簇内平方和)的简单方法。该算法的一个特点是:你需要预先指定簇的数量 k。
该算法将一组包含 N 个样本的数据划分成 k 个互不重叠的簇 。每个簇由其内部数据点的均值 描述, 被称为簇的质心。
该算法的目标是最小化如下目标函数(即惯性或簇内平方和):
K-means 等价于一种期望最大化(EM)算法,其协方差矩阵很小、各分量相等且为对角阵。以下是求解聚类的标准两步过程,在其他资料中你也可能会看到 E-step(期望步)和 M-step(最大化步)的说法。
给定初始的 k 个均值 ,令 表示 k 个簇,每个数据点被分配到其中一个簇中,且仅属于一个簇。
-
将每个观测点分配给距离最近的均值所对应的簇,通常使用最小平方欧氏距离。每个数据点 被分配到某个 中:
-
重新计算每个簇中已分配数据点的均值(即簇的质心):
当数据点的簇分配不再发生变化时,算法收敛。
理论部分到此结束,接下来我们动手编程!
在生成的数据上进行聚类
让我们来看看它的实际效果以及我们可以做些什么。
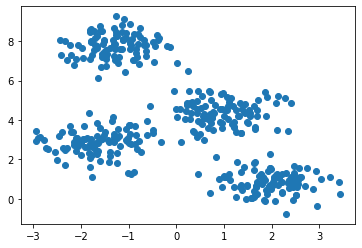
首先,创建一个具有四个中心的数据集,并绘制如下图所示的结果。此处暂不展示数据生成代码,完整代码将在后面给出。从下图可以看出,数据点自然形成了四个簇。
我们从 cluster 模块中创建一个 KMeans 对象。由于我们知道数据集有四个中心,因此只需设置参数 n_clusters=4 并调用 fit 方法。
1from sklearn.cluster import KMeans
2
3km = KMeans(n_clusters=4)
4km.fit(X)
然后查看结果。我们可以通过根据每个数据点所属的簇为其着色来可视化结果。
以下是完整的代码,你可以自己尝试运行:
1import sklearn.datasets as datasets
2import matplotlib.pyplot as plt
3from sklearn.cluster import KMeans, SpectralClustering
4
5X, y = datasets.make_blobs(400, centers=4, cluster_std=0.6, random_state=0)
6
7km = KMeans(n_clusters=4)
8km.fit(X)
9
10pred_y = km.predict(X)
11fig1, axe2 = plt.subplots()
12axe2.scatter(X[:, 0], X[:, 1], c=pred_y)
13fig1.savefig("output/img.png", dpi = 300)
14plt.close(fig1)
首先,通过 make_blobs 函数生成一个参数为 centers=4 的数据集,表示该数据集包含四个簇。
第7行使用 KMeans 创建了一个 k-means 对象。因为我们已知数据集有四个簇,所以传入参数 n_clusters=4。然后在第8行对该对象进行训练。
从第11行到第14行,我们尝试绘制数据集,并根据第10行的预测结果为数据点着色。第10行会对每个数据点预测其所属的簇。该图为散点图,从图中可以看出,该数据集确实可以清晰地分为四个不同的簇。
k 值对性能的影响
k-means 最大的缺点之一是你必须手动指定超参数 K。如果 K 设置得过大或过小,都会对结果产生较大影响。
下图展示了不同 K 值下的聚类结果。可以看出,当 K 设置不正确时,结果会明显变差。
有没有方法可以选择合适的 K?或者是否存在能自动确定最佳 K 的聚类算法?答案是有的,但这些方法并不完美。例如 affinity propagation、mean shift 和 DBSCAN。但请记住,不存在万能的方法。虽然这些算法不需要指定 K,但它们仍然依赖其他超参数。你需要根据实际情况进行选择。若想深入了解这一主题,可参考相关资料。
以下是不同 K 值的完整代码,供你尝试:
1import sklearn.datasets as datasets
2import matplotlib.pyplot as plt
3from sklearn.cluster import KMeans
4
5X, y = datasets.make_blobs(400, centers=4, cluster_std=0.6, random_state=0)
6
7plt.tight_layout()
8fig3, axe3 = plt.subplots(nrows=1,
9                          ncols=4,
10                          figsize=(14, 6), dpi=800)
11for k in range(2, 6):
12    km = KMeans(n_clusters=k)
13    km.fit(X)
14    pred_y = km.predict(X)
15    axe3[k - 2].scatter(X[:, 0], X[:, 1], c=pred_y)
16    axe3[k - 2].set_title("cluster with k={}".format(k))
17fig3.savefig("output/img.png", dpi = 300)
18plt.close(fig3)
首先,通过 make_blobs 生成一个包含四个簇的数据集。
第8行创建了一个包含子图(一行四列)的图形,后续结果将绘制在此图上以便比较。
第11至16行为一个循环 k in range(2, 6),其中 k 表示数据集中簇的数量。在每次迭代中,创建对应 k 值的 k-means 模型,进行训练和预测,然后在子图中绘制数据并按预测结果着色(第15行)。
什么是谱聚类(Spectral Clustering)?
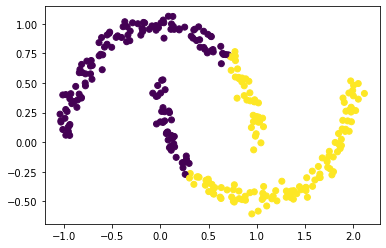
k-means 对数据分布有一个隐含假设:即数据在相应空间中的分布呈球形。如果不满足这一条件,k-means 很难有效学习。
看下面这个例子。在这个演示中,我们创建了一个包含两个簇的数据集,但其形状并非圆形。此时使用 k-means 进行聚类,结果失败了,因为它无法处理这种复杂的边界。
1X, y = datasets.make_moons(300, random_state=12, noise=0.05)
2
3km = KMeans(n_clusters=2)
4km.fit(X)
5pred_y = km.predict(X)
6
7fig4, axe4 = plt.subplots()
8axe4.scatter(X[:,0], X[:,1], c=pred_y)
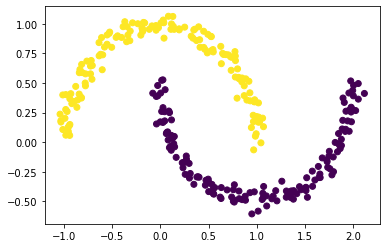
如何解决这个问题?在聚类中有一种方法叫做 Spectral Clustering。它利用最近邻构建的图结构来计算数据的一种新表示形式,然后使用 k-means 算法进行标签分配。该方法使用非常简单,只需调用 SpectralClustering 即可。
1from sklearn.cluster import SpectralClustering
2sc = SpectralClustering(n_clusters=2, affinity='nearest_neighbors',
3                        assign_labels='kmeans')
4# X 是你的数据
5sc.fit(X)
1import sklearn.datasets as datasets
2import matplotlib.pyplot as plt
3from sklearn.cluster import KMeans, SpectralClustering
4
5X, y = datasets.make_moons(300, random_state=12, noise=0.05)
6
7fig, axe = plt.subplots(dpi=800)
8sc = SpectralClustering(n_clusters=2,
9                        affinity='nearest_neighbors',
10                        assign_labels='kmeans')
11sc.fit(X)
12pred_y = sc.fit_predict(X)
13axe.scatter(X[:, 0], X[:, 1], c=pred_y)
14fig.savefig("output/img.png", dpi = 300)
15plt.close(fig)
从上述输出可以看出,尽管数据分布较为复杂,SpectralClustering 仍能完全分离这两个簇。这种方法使用了核技巧。如果你之前学过关于 SVM 的课程,你应该知道:当数据非线性可分时,核函数 是一种强大的工具。