


卷积的原理
了解卷积操作及其在深度学习中的应用。
为什么使用卷积?
我们之前见到的全连接层并不尊重输入数据的空间结构。例如,当输入是一张图像时,神经网络会将二维结构破坏,展平为一维向量。为了解决这个问题,人们设计了卷积神经网络(CNN)。这类网络在计算机视觉任务中表现极为出色。
在处理图像时为何要使用卷积?因为我们事先知道,相邻像素通常具有相似的特征,因此我们希望在网络设计中显式地利用这一先验知识。这种假设被称为归纳偏置(inductive bias)。
卷积层充分利用了数据的局部结构特性。
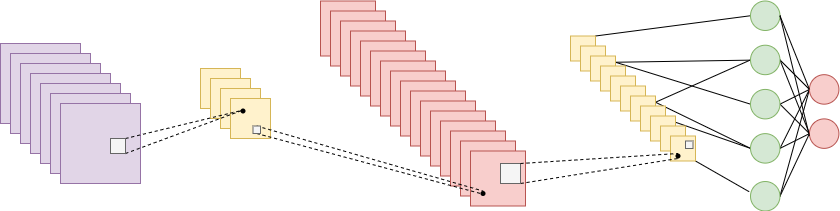
但如何才能专注于局部结构,而不是像全连接层那样对整个输入做线性组合呢?
答案非常简单:我们将卷积层的操作限制在一个称为“卷积核”(kernel)的局部窗口上,然后在整个输入图像上滑动这个窗口。
卷积操作
卷积神经网络的基本运算就是卷积。数学上,两个二维函数之间的卷积定义如下:
尽管在数学中,其中一个信号在滑动前需要翻转,但在深度学习中通常忽略这一点。原因在于卷积核内部的权重是可训练的,网络会自动学习合适的参数。
直观来看,我们可以将一个 2×2 的卷积核作用于一个 4×4 的图像,如下图所示:
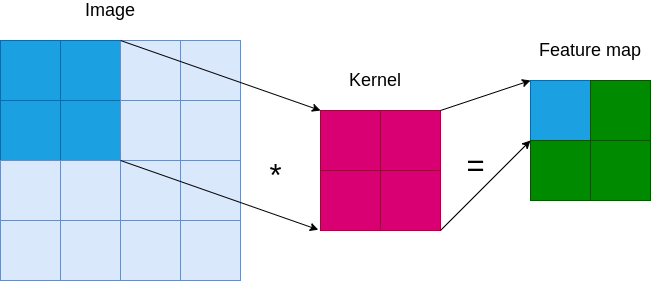
尝试想象卷积核在图像上滑动的过程。注意,每次卷积核与图像区域之间的运算实际上是点积运算,结果是一个标量(在输出中以蓝色显示)。
该输出被称为特征图(feature map)。
可以看出,给定一个矩阵(输入)和一个较小的权重矩阵(卷积核),我们可以生成一个标量值。这个数值本质上是输入局部区域与卷积核之间点积的结果。
值得注意的是,这种点积实际上衡量了两者的相关性(或相似度)。卷积神经网络擅长学习邻近像素之间的空间相关性。
下面是一个图像中 3×3 区域(称为图像块,patch)与一个 3×3 卷积核进行卷积的例子:
再次强调,这只是一个简单的点积运算。
总结一下: 给定一个 的输入矩阵和一个 的卷积核(其中 ):
- 我们将卷积核在输入矩阵的所有可能位置上滑动;
- 在每个位置执行一次点积运算,得到一个标量;
- 将所有这些标量汇总起来,形成输出,即特征图。
那么我们实现了什么目标?
我们将输入空间中的一个二维矩阵转换到了特征空间,同时保留了其二维结构。这样,网络能够捕捉仅出现在图像局部区域的上下文信息,而这些信息若使用全连接层则会被丢失。
直观上,卷积神经网络能够识别图像中的模式,如边缘、角点、圆形等。从另一个角度看,卷积神经网络可以被视为一种局部连接的神经网络——与全连接网络不同,特征图中的每一个像素只受输入图像的一个局部区域影响,而非整幅图像。
重要说明
- 卷积仍是一种线性运算。
- 卷积核中的权重是可训练的,并且在整个输入上共享。
- 每次点积运算都反映了输入局部区域与卷积核之间的相似程度。
- 卷积操作可以在任意维度上进行。
- 滑动的方向决定了卷积的维度:对于图像,是二维卷积;但对于具有一维局部结构的序列数据,也可以应用一维卷积。
如果你理解了卷积的基本原理,就应该能够用 Python 从零实现卷积操作。这只需要几行代码。在下面的练习中,你将编写一个函数,接收一个二维图像和一个二维卷积核,输出它们的卷积结果。
你的代码将在四张不同的图像上进行测试。卷积核大小始终为 (3, 3),而图像尺寸分别为 (8, 8)、(12, 10)、(10, 10) 和 (12, 8)。
1import torch
2
3def conv2d(image, kernel):
4    pass