


运行第一个 Spark 程序
让我们运行我们的第一个 Java Spark 程序。
一个简单的示例
让我们从一个非常简单的例子开始我们的 Spark 学习之旅。
源代码
我们来逐步分析下方小工具中提供的代码。
No configuration found for ID: e20da2033f3f23acc07c6df4ca4747882db8adcd81110ccd9aaa0006421c383e
注意:Spark 是一个纯后端处理工具,不提供用户界面,除了 SparkUI 监控工具外。
目前,我们无需关注 Maven 项目结构以及所有必要的依赖项。这部分内容将在 “基于 Maven 的 Spark 项目” 一课中详细讲解。
示例应用程序
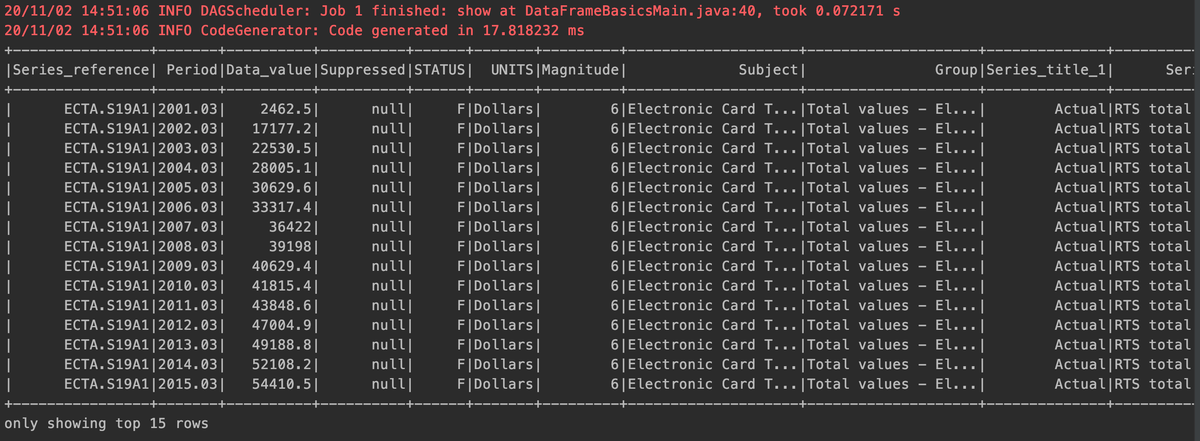
我们的第一个应用程序是一个基础的数据读取与输出程序。通俗地说,它从源(CSV 文件)读取数据到一个占位对象(DataFrame)中,并将前 15 条记录打印到输出流(sysout)或终端中。
代码解析
程序的入口点是一个包含 main 方法的类,名为 DataFrameBasicsMain。在其中,创建了该类的一个实例,并调用 init() 方法来启动程序执行:
1public static void main(String[] args) {
2  DataFrameBasicsMain dataFrameBasicsMain = new DataFrameBasicsMain();
3  dataFrameBasicsMain.init();
4}
在 init() 方法内部,我们将创建一个 SparkSession。这是针对当前工作单元的应用会话,通过指定应用名称以便在日志中追踪多个任务时识别应用。我们设置主节点为本地(本地运行模式),如下代码所示:
1// 在本地主机上创建 Spark 会话。
2SparkSession sparkSession = SparkSession.builder()
3                .appName(APP_NAME)
4                .master(LOCAL_NODE_ID)
5                .getOrCreate();
接着,我们使用该会话加载存储在 CSV 文件中的数据,调用 read() 方法并指定与文件扩展名匹配的输入格式:
1// 读取带有表头的 CSV 文件,并将其存储为 DataFrame。
2Dataset<Row> df = sparkSession.read().format(FORMAT)
3                    .option("header", "true")
4                    .load("src/main/resources/spark-data/electronic-card-transactions.csv");
上述代码中一个值得注意的方法是 .option("header", "true")。该方法告诉 Spark 将 CSV 文件的第一行视为列名,对应数据结构中的字段名。
最后,我们通过调用 DataFrame 的 show(...) 方法显示前 15 条记录:
1df.show(15);
就这样!无论文件有 5 行还是 500 万行,Spark 都能为我们完成繁重的工作,并提供简单直接的方法来操作这个 DataFrame 中的数据。
要本地运行此程序(脱离小工具环境),并在控制台查看结果,通常可以通过以下两种方式之一实现:
-
通过 IDE 运行:只需右键点击包含
main方法的类文件(DataFrameBasicsMain.java),然后选择“Run DataFrameBasicsMain…”即可。 -
通过 Maven 运行:该项目使用了 Maven 执行插件,因此可以在终端或项目根目录下输入命令
mvn clean install exec:exec,以完成编译、构建并运行程序。
程序运行后,输出将以人类可读的格式展示结果,并打印出 15 条记录:
第一种方式需要我们在本地电脑或笔记本上进行项目开发、运行和调试。这在附录章节的 “IntelliJ:调试与检查 Spark 执行” 课程中有详细介绍。
强烈建议大家亲自运行并调试这些 Spark 项目。这种实践不仅能让开发者随时修改代码并重新运行以观察效果,还能在运行时检查变量及其值。
此外,这一过程还有一个有趣的附加好处:它帮助开发者熟悉 Spark 项目特有的细节和运行特性。