


问题描述
让我们学习自动驾驶汽车如何利用语义图像分割来“感知”周围环境。
简介
自动驾驶汽车的定义是:一种能够在极少或无需人工干预的情况下自主行驶的车辆。其系统通过多种传感器感知周围环境,例如识别可行驶区域、天气状况、前方障碍物,并据此规划车辆的下一步操作。
这类车辆具有不同的自动化等级。目前特斯拉实现的是辅助驾驶,即车辆可以自主驾驶,但仍需驾驶员坐在驾驶位上。而Waymo(谷歌的自动驾驶汽车)则致力于在所有驾驶条件下实现完全自主驾驶(无需驾驶员)。除了载人出行,自动驾驶车辆还可用于多种服务场景,例如Nuro正在开发用于本地货物运输的自动驾驶车辆。
📝 自动驾驶车辆是处理多传感器输入的理想现实系统,尤其侧重于基于计算机视觉的问题(如物体分类/检测/分割),并广泛使用机器学习技术。
了解了背景信息后,我们来看一下问题描述。
问题陈述
面试官要求你设计一个自动驾驶汽车系统,重点关注其感知组件(特别是语义图像分割)。该组件将使车辆能够感知周围环境,并做出合理的驾驶决策。不用担心,接下来我们会详细介绍什么是语义图像分割。
面试官可能提出的问题
面试官可能会围绕这个问题逐步缩小范围,提出以下问题:
-
从自动驾驶汽车的角度出发,你会如何处理基于计算机视觉的问题?
-
如何为自动驾驶任务训练一个语义图像分割模型?
-
分割模型在整个自动驾驶系统架构中处于什么位置?
-
当图像数据集存在数据稀缺时,该如何应对?
-
如何在图像上最有效地应用数据增强?
-
图像分割任务中最优的模型架构有哪些?
-
你优化后的深度学习模型在验证集上表现良好,但在实际道路上却失败了,原因是什么?如何解决?
📝 回答说明
Q1将在讨论“子任务”时给出解答。
Q2和Q3将在“架构组件”课程中回答。
Q4、Q5和Q7将在“训练数据生成”课程中解答。
Q6将在“建模”课程中详细说明。
📝 面试中遇到的其他类似(多传感器)计算机视觉问题,也可以采用与自动驾驶问题相似的方法来解决。
在尝试回答第一个问题之前,我们先快速了解一下自动驾驶系统的主要软硬件组成部分。
硬件支持
下面我们来看让车辆能够“看”和“听”环境,并据此规划行动路径的传感器。
🔹 相机
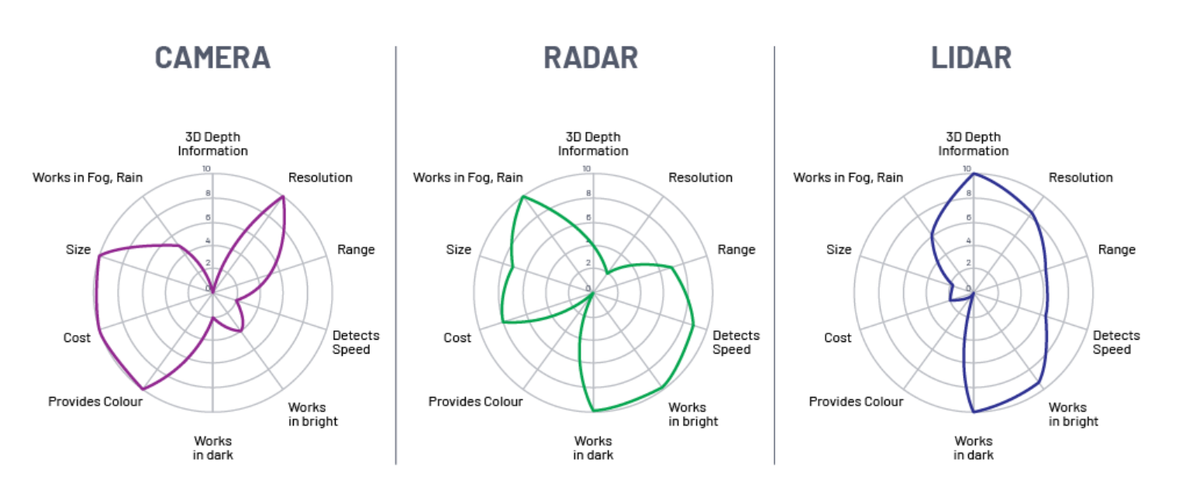
相机为系统提供高分辨率的视觉信息。基于帧的相机视觉输入还可用于估算物体与自动驾驶汽车之间的深度/距离。然而,相机的有效性高度依赖光照条件,在夜间等低光环境下可能无法正常工作。
🔹 雷达
雷达利用无线电波从固体物体上的反射来探测其存在。它在视觉信息基础上增加了深度感知能力,使系统能准确判断不同物体间的距离。雷达在各种复杂条件下(如弱光、灰尘、阴天)以及远距离操作中均表现良好。
🔹 激光雷达(Lidar)
与雷达不同,激光雷达使用激光照射物体并接收反射信号,从而构建出环境的精确三维图像,并测量物体所处的距离。它甚至能有效检测到小型物体。但其在雨天或雾天性能下降,且成本较高。
📝 行业内已有的一种做法是融合上述多种传感器输入,以弥补单一传感器的不足。
下图很好地对比了各类硬件支持的特点:
🔹 麦克风
以上介绍了作为自动驾驶系统“眼睛”的设备,现在我们来看看系统的“耳朵”。
当人听到救护车警报声时,可以判断声音来源及其移动的速度和方向。类似地,自动驾驶车辆也使用麦克风收集周围音频信息。
📝 听觉信息还能帮助系统判断天气状况。例如,通过车辆行驶在路面上的声音,可以判断路面是否潮湿(是否下雨),从而决定降低车速。
至此,你已经了解了为自动驾驶车辆提供输入数据、使其感知环境的各种工具。
子任务
从环境感知到运动规划的整个流程,可分解为多个机器学习子任务,下面将逐一介绍。
在计算机视觉领域,前三个子任务代表了可用于处理图像数据集(例如本例中的驾驶图像)的方法,如分类、定位、分割等。我们通过一个例子来逐步拆解,理解如何应对如此规模的问题。
早上出发,你的任务是让自动驾驶车辆从波士顿开往纽约市。假设此时车辆正行驶在阳光明媚、天空晴朗、交通稀疏的高速公路上。如果你用标注好的数据训练了一个图像分类器,并将实时摄像头画面输入其中,可能会得到如下平均分类得分:{"汽车":0.1, "道路":0.5, "天空":0.3, "树木":0.05, "其他":0.05}。
这个分数大致反映了环境中存在的物体类别,但它无法指出这些物体的具体位置。这个问题可以通过图像定位器解决,它可以生成边界框,标出预测物体的位置。这就引出了第一个子任务——目标检测。
-
目标检测
在目标检测中,我们检测周围环境中不同类别的物体实例(如绿化带、围栏、汽车、道路、山体等),并通过绘制边界框对其进行定位。
继续扩展这个例子,问题变得更复杂。中午你进入纽约市区,遇到中等程度的交通。此时图像定位器会产生大量重叠的边界框。为了更好地处理这种情况,你需要升级系统,对物体类别进行分割,以找到车辆的最佳通行路径。于是你构建了一个图像分割器,通过语义分割,在分类和边界框的基础上生成预测的二值掩码/类别。这引出了第二个子任务——语义分割。
-
语义分割
语义分割可以看作是对图像的像素级分类。同一类别的物体被赋予相同的标签,如下图所示。
再进一步增加难度:现在你需要在曼哈顿一条非常繁忙的街道(例如时代广场)驾驶自动驾驶车辆。在这种情况下,必须以高精度实时分割出每一个独立物体。为此,你将系统从语义分割升级为基于实例的分割,即在边界框和分类基础上生成每个对象的预测二值掩码。这就引出了第三个子任务——实例分割。
-
实例分割
语义分割无法区分同一类别下的不同个体。而实例分割结合了目标检测与分割技术,对每个物体实例的像素进行分类。它首先检测某个具体对象(特定实例),然后对其像素进行分类。输出结果如下图所示:
-
场景理解
这一步的目标是理解周围正在发生的情况。例如,你发现有人正朝车辆走来,需要踩刹车;或者如下图所示,高速公路上前方有一辆车正在行驶。
-
运动规划
在完成物体识别、图像中独立物体的分割以及场景理解之后,下一步就是为自动驾驶车辆制定运动计划。例如,由于前方有车,你可能决定减速(踩刹车)。
本章将重点讨论第二个子任务,即以下机器学习问题: